概要
Attention の仕組みでは、query がすべての key と照らし合わされ、各 value は、その key が query に合う度合いに応じて読み出される。 そのため、key は番地、value は中身と見なされることが多い。 value が中身を運ぶことは確かめられているが、key が呼び出す value が、その key が呼び出すべき事実を持つかは、ほとんど確かめられていない。 これを確かめるため、本論文では、2 人についての事実を 1 つずつ述べる、決まった型から作った短い prompt で、主に 3 つの実験を行う。 第 1 に、2 つの事実の cache の value か key を入れ替える。 第 2 に、問いを変えたときに、選んだ attention head がどの token を見るかを測る。 第 3 に、2 つの value を、これらの head が使う key-value head の中だけで入れ替える。 その結果、多くの LLM で、2 つの value を入れ替えると、ほぼすべての例で答えがもう一方の事実に切り替わる。 すべての LLM で、もう一方の事実について問うと、選んだ head の attention がその事実の token へ移り、一部の LLM では、2 つの value をそれらの key-value head の中だけで入れ替えても答えが切り替わる。 これらの結果は、ある事実を指す key で呼び出される value が、その key が呼び出すべき事実を持つ、という主張を支持する。 また、長い prompt では、2 つの key の回転だけを入れ替えた時に、同じ量だけ無作為に動かすより多く、答えがもう一方の事実に変わることも分かった。
Introduction
Transformer は attention で文脈を読む。 ある位置での attention head の出力は、その位置とそれより前の位置の value の重み付きの和であり、重みはその位置の query とそれらの位置の key の内積から計算する(§3 節の式 (1))。 Miller et al. [1] の key–value の記憶では、query は番地としての key と照らし合わされ、組になった value を中身として読み出す。 attention も同じように働くのであれば、key と value は対応しているはずであり、ある事実を指す key で呼び出される value は、その事実を持っているはずである。 value が中身を運ぶことはこれまでの研究で示されている [4][5] が、この対応が成り立つかを直接確かめた研究は少ない。 私たちは、この対応を 2 つの部分に分けて確かめる。 部分 (a) は、問われた事実を述べた token と別の事実を述べた token の value を入れ替えると、答えがその別の事実に変わるかを問う。 部分 (b) は、出力が最初の答えの token を予測する、prompt の最後の token での query が、問われた事実の token をその key によって選ぶかを問う。
これまでの研究は、key や value を、prompt のすべての token で、または事実の token だけで、対にした counterfactual な入力のものに差し替えてきた [4][8][7]。 これらの確かめでは、patch したベクトルは別の入力から計算されたものなので、答えの変化は、元の入力が述べていない中身や、そのベクトルを計算した別の文脈から来ることもありうる。 別の確かめは、同じ入力の中で 2 位置離れた数の 2 つの token の key を、ある層とそれより後のすべての層で入れ替える。 入れ替えで期待される答えの確率は上がるが、正しい答えの確率を下回ったままである [2]。
私たちは、数十 token 離れた 2 つの token の key か value を全層で入れ替え、入れ替えを読むのは最後の位置だけにする。 文脈は 2 人の好きな色を述べ、問いは Alice の色を問う。 prompt の最後の token の手前までを prefill してから、色を表す 2 つの token のすべての層と KV head で、cache の key(key の入れ替え)、value(value の入れ替え)、または両方を入れ替える。 最後の位置とは、prompt の最後の token と生成する token である(図 1)。 それより前の位置は一度も計算し直さないので、value の入れ替えでは、cache の中の key の集合と value の集合は変わらず、どの key とどの value が組になるかだけが変わる。 入れ替えた key には、移した先の位置で RoPE を掛け直す。
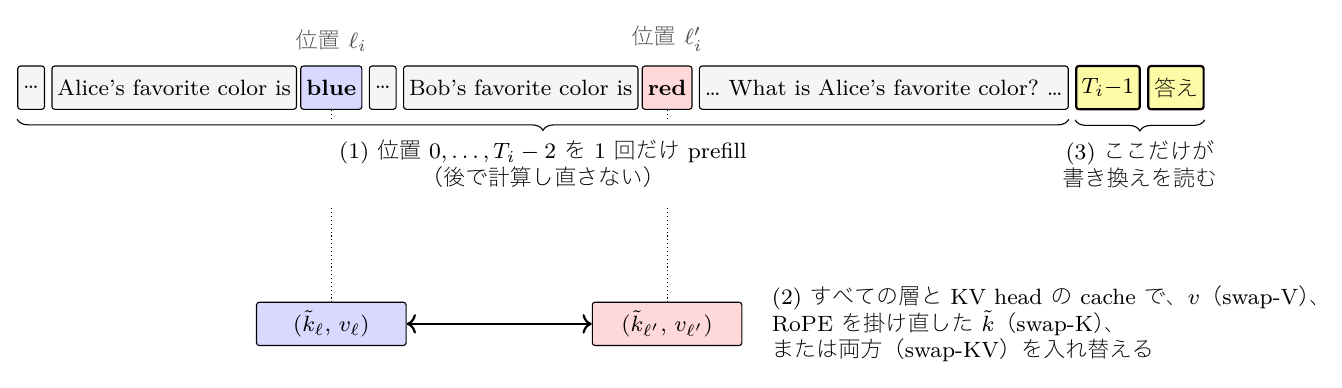
図1|cache の書き換えの図示。 (1) cache を作るため、prompt を最後の 1 つ前の token まで 1 回だけ流す。 (2) 色を表す 2 つの token の value、key、またはその両方を、すべての層と KV head で入れ替える。 (3) prompt の最後の token と生成する token だけが書き換えを読むので、答えの変化はこの書き換えから来る。
最後の位置が見るのは (key, value) の組の多重集合だけなので、key の入れ替えは、value の入れ替えに 2 つの key の rotary position embedding(RoPE)の位相の入れ替えを重ねたものと等価であり、key と value の両方を入れ替えることはこの位相の入れ替えだけと等価である(§3.2 節)。 そのため、key の入れ替えの後の答えの変化には、value の入れ替えの効き目と RoPE の位相を動かした効き目が重なっており、query が key の中身を使っているかは、それだけでは分からない。 部分 (b) を確かめるため、私たちは代わりに attention を測る。 別の試行で、prompt の最後の token からの attention が問われた人の色を表す token を重く見る head を選んだ head として選び(§4.4 節)、その attention が key の中身に従うかを見る。
指示調整した 6 モデル(表 11)で、次のことを観察した。
-
2 つの value を入れ替えると答えが変わる(部分 (a))。 2 つの色を表す token の value だけを入れ替えると、6 モデルのうち Llama-3.1-8B を除くすべてで、定型文の prompt でも物語の prompt でもほぼすべての試行で、6 token の答えがもう 1 人の色を含む(§4.3 節)。
-
選んだ head の attention は、問われた人の token の key の中身に従う(部分 (b))。 1 つの層だけの key の入れ替えでは、(試行, head)の組の多くで選んだ head の score がおもに key の中身に従う。 Alice の代わりに Bob について問うと、その attention は Alice の色を表す token から Bob の色を表す token へ移り、どちらの結果も 6 モデルすべてで成り立つ(表 8、図 3、§4.4 節)。 選んだ head について、これらの観察は部分 (b) を支持する。 しかし、1 つの層だけの key の入れ替えを、6 モデルのうち OLMo-2 を除くすべてで 40 試行ずつ流すと、答えに Bob の色が入るのは多くてもその 4 分の 1 なので(付録 H.2)、この attention が答えを決めることを私たちは示していない。
-
2 つの value を選んだ head が使う KV head の中だけで入れ替えると、2 モデルで答えが変わる(部分 (a) と (b) をつなぐ)。 Phi-3.5-mini と OLMo-2 では、2 つの value を選んだ head が使う KV head の中だけで入れ替えるとほぼすべての試行で答えが変わるが、同じ大きさの無作為な集合ではめったに変わらない。 残る 4 モデルでは、基準を満たさないか、判定不能である(§4.5 節)。
観察 1 と 2 は、この課題と、6 モデルのうち Llama-3.1-8B を除くすべてで、Alice を指す key で呼び出される value が、その key が呼ぶべき事実である Alice の色を持っている、という主張を支持し、観察 3 は 2 つのモデルで 2 つの部分をつなぐ。
Chowdhury et al. [2] が調べた唯一のモデルである Llama-3.1-8B は例外である:定型文の prompt では、value の入れ替えの後に答えが Bob の色を含むのは Alice の事実が先に来るときだけである(§4.3 節)。 長い文書での検証では、Olmo-3 を除くすべてのモデルで、位相の入れ替えで答えが Bob の色に変わる割合が、2 つの key の一方だけを動かしたときの割合の和より大きい。またすべてのモデルで、2 つの key を同じ総量だけ無作為に動かすより多く、答えが Bob の色に変わる(§4.6 節)。 ほかの結果はすべて、2–3 人・1 つの属性の、決まった型から作った短い prompt から得たものである(§5 節)。
Related Work
番地と中身としての key と value 記憶を持つネットワーク [1] と attention [12] では、key がどの項目を読むかを決め、value が何の情報を読むかを決める。 回路の分析も同じように分け、query–key の回路がどの token に attention を向けるかを決め、output–value の回路が何の情報を運ぶかを決める [13]。 Prakash et al. [3] は学習したモデルの lookback の仕組みを記述しており、そこでは、後ろの token で pointer から作られた query が、前の token で番地から作られた key と合い、attention がその番地と並べて置かれた中身を取り出す。 これらのどの研究も、学習したモデルの中で特定の位置の key や value を書き換えて、この区別を確かめてはいない。
別の入力の中身を持ち込む確かめ 多くの確かめは、同じ位置の key や value を、別の入力や別のモデルのものに差し替えるか [4][5][6][14][7][8]、別の入力での head の出力から後ろの head の key・query・value を計算し直す [15]。 Dinh et al. [4] は prompt のすべての token で差し替えており、どの token の value が読まれたかを示さない。 Dinh et al. [4] と、Ding et al. [5] の GPT-2 の規模のモデルでは、value のほうが key より答えへの効果が大きく、Lin et al. [6] では、value のほうが key より安全性のふるまいへの効果が大きい。 これに対し、事実の token だけを patch する Bogdan et al. [7] では、patch する token が前の人物の表現を持つとき、key を patch したときの効果のほうが大きく、著者らは後ろの位置を計算し直すかを明記していない。 Wu et al. [8] も事実の token だけを patch するが、key と value をまとめて動かす。
activation patching、attention knockout と、どの位置が書き換えを読むか causal tracing [16]、選んだ head の value の patching [17]、すべての head での attention knockout [11] は、key だけを patch することも、同じ入力の 2 つの位置の間で key や value を写すこともしていない。 Feng et al. [9] は、token の RoPE [18] の位置に介入してその活性を別の位置へ動かし、それでモデルのふるまいがほとんど変わらないことを報告しており、私たちの位相の入れ替えは、この変更を、色を表す 2 つの token の cache の key に当てたものである。
同じ入力の中での入れ替え Chowdhury et al. [2] は、1 つの入力の 2 つの位置の間で key を入れ替える。 著者らは、後ろの区間が前の区間の差を繰り返す数列で Llama-3.1-8B を調べ、2 位置離れた 2 つの数の token の key を入れ替え、もう一方の位置に置かれた差を写したときの答えを予想する。 入れ替えはある層から後ろに当て、2 つの位置の value は変えずにおく。 その答えの確率は上がるが、正しい答えの確率より低いままである。 この key の入れ替えは、それぞれの key を自分の RoPE の位相とともに動かす(、付録 A)ので、入れ替えた 2 つの位置の両方に attention を向ける位置には、value の入れ替えの後と同じ (key, value) の組が見える(§3.2 節)。 著者らは入れ替えを当てる層は明記しているが、入れ替えた key をどの位置が読むかは明記しておらず、私たちは 2 つの token の位置の cache の中身を入れ替えたものを最後の位置だけに読ませる(§3.1 節)。 著者らの結果では正しい答えの確率が高いままだが、私たちの色の課題では、6 モデルのうち Llama-3.1-8B を除くすべてで、value の入れ替えにより、ほぼすべての試行で答えがもう 1 人の色に変わる(§4.3 節)。 著者らは、正しい答えが上のままであることを value の中の情報に帰している。 私たちの Llama-3.1-8B の結果では、1 つの説明の候補は、最後の位置より前の token が元の色を後ろへ運ぶことであり(付録 H.5)、著者らの設定でそのような token が寄与するかは私たちは測っていない。
私たちが足すもの 同じ入力の数十 token 離れた 2 つの位置の key だけ、または value だけを全層・全 KV head で入れ替え、最後の位置だけにそれを読ませた先行研究を、私たちは知らない。 key の入れ替えと value の入れ替えを文脈の長さの間で比べた研究も、私たちは知らない。 Li [10] と同じく、私たちは cache の key を別の位置へ動かすときに RoPE の回転を掛け直し、この選び方が 1 つの入力の中の入れ替えについて何を意味するかを §3.2 節で分析する。
Preliminaries
記号 試行 について、prompt は 個の token からなり、cache の項目を入れ替える 2 つの token は位置 にある(私たちの課題では Alice と Bob の 2 人の色を表す token。§4.1 節)。 モデルは 個の層、 個の KV head、 個の query head を持ち、その番号を 、、 で表す。 multi-head attention では、query head ごとに自分の key と value がある。grouped-query attention [19] では、いくつかの query head が 1 つの KV head の key と value を共有する。 query head が使う key と value を持つ KV head を と書き、rotary position embedding(RoPE)を掛けた後の位置 の head の query を と書く。 層 ・KV head ・位置 の cache の項目は、RoPE を掛けた後の key と value からなる。 ・ は、位置 の RoPE の回転 [18] を掛ける・外す操作である。 この回転を掛ける前の key を、key の中身と呼ぶ。 1 つの層と query head について、・・ を省くと、位置 での head の出力は
である。
3.1 cache の書き換えと、それを読む位置
まず prompt の位置 を介入なしで通して cache を作る。 次に cache を書き換え、残りの prompt の位置 を書き換えた cache で処理してから答えを生成する。 2 つの色を表す token は、 より前の別々の位置にある: かつ 。 書き換えは層の集合 と KV head の集合 に当て、既定ではそのすべてに当てて (prompt の最後の token の位置)とし、書き換えは次のとおりである(、 について)。
どの代入も同時に行うので、各右辺は書き換える前の cache を使う。 参考として、書き換えなし(none)のモデルと、参考の 2 つの書き換え patch-V と mask-A(付録 A)も示す。
なぜ最後の位置だけに読ませるか forward の途中で書き換えると、後ろのすべての位置がそれを読み、それらの位置が後の層で持つ key と value は、書き換えた状態から計算される。 prompt は有限の語彙の、長さに上限のある列なので([33] も同じ仮定を置く)、書き換えていない prompt からモデルが作りうる key と value は有限の集合をなし、後ろの位置が書き換えた状態から計算する key と value は、この集合から外れうる。 そういうベクトルは、モデルが学習で見たものと違いうるので、それを読むとモデルは分布の外に置かれることがある。 これは activation patching でも挙げられてきた懸念である [17][20]。 答えの変化は、どの value がどの key と組になっているかではなく、そのベクトルから来うる。 key だけの入れ替えには、2 つ目の問題が加わる:位置が、入れ替えが一部だけ及んだ状態から計算し直される。 たとえば、書き換えた 2 つの位置の間にある位置には、causal mask のためそのうち前の位置だけが見え、そこでは入れ替えて入った key と元の value が組になっていて、後ろの位置はその位置が計算したものを読みうる。 コンマ、ピリオド、区切りの token は、感情 [21] や、prompt の中の項目から計算された結論 [10] のような前の token の情報を蓄え、後ろの位置がそれを読むことが知られている。 そこで私たちは位置 を計算し直さないので、書き換えを読むのは とそれより後ろの位置だけであり、そういうベクトルを計算するのもこれらの位置だけである。 prompt の最後の token と生成する token は書き換えた 2 つの位置の両方に attention を向けるので、これらの位置にとって、各 key の元の回転を保つ key の入れ替え(、付録 A)は value の入れ替えと厳密に等しい。
3.2 入れ替えの間の等価
1 つの層・1 つの KV head で(上付きは省く)、 と を Alice と Bob の色を表す token の key の中身、 をそれらの value とする。 位置 のどの query の出力も、それが attention を向ける(key、value)の組の多重集合だけで決まり、どの位置がどの組を持つかにはよらない。 各 key の中身を保ったまま、もう一方の位置の RoPE の位相を与える位相の入れ替えを、次のように定める:
各書き換えでの組の多重集合を比べると(付録 G.2 の図 5)、丸め誤差を除けば、すべての query の位置 について次が成り立つ:
これらの等価が成り立つのは、そのような query からは 2 つの位置がどちらも見え、モデルが RoPE のほかに位置で変わる項を足さず、dropout も無いからである。 そのため、key と value の両方の入れ替えは位相の入れ替えだけを試す。 key の入れ替えと value の入れ替えの両方が答えを変えても、それが示すのは位相の入れ替えが value の入れ替えの効き目を打ち消さないことだけなので、key の入れ替えは value の入れ替えから独立な証拠にならない。 key に固有の証拠は、書き換えの後に測った attention(§4.4 節)から得る。2 つの key の複製は付録 G.3に載せる。
Experiments
4.1 課題
各試行は、8 つの中立な文の中で Alice と Bob の 2 人の好きな色を述べ、"What is Alice's favorite color? Answer with one word." と問う。 2 つの色 blue と red はいつも違い、2 つの事実の順は確率 1/2 で逆にする。 定型文の prompt では各事実を "Name's favorite color is color." と書き(付録 E)、物語の prompt では事実を短い話の中で 4 つの言い回しのどれかで書く。 greedy decoding で最大 6 個の新しい token を生成し、各条件 試行を使う。 表 11(付録 G.7)に、6 つのモデルと、長い文書の実験(§4.6 節)と §4.4 節・§4.5 節の対照で使う Olmo-3-7B-Instruct を示す。
4.2 評価
色を含む答えの割合 について、小文字にした答えが の色を部分文字列として含む試行の割合を
とする。
答えの分類 答えにもとづく判定(付録 B)では、答えを 3 つの分類のどれかに、3 人の課題では 4 つの分類のどれかに分ける(§4.3 節)。 答えを Alice の色(A)か Bob の色(B)に分類するのは、答えがちょうどその色か、決まった前置きの後のその色だけのときに限り、ほかは とするので、説明を足した答えは に分類されるが、 には数える。 条件 について、 は に分類される試行の割合、 は に分類される試行の割合、 は 2 つの条件で分類が同じ試行の割合である(付録 G.1)。
判定 各判定は、答えの分類か attention の重みに基準(付録 B)を当て、その結果は、満たす・満たさない・判定不能のどれかである。 答えにもとづく判定を判定不能とするのは、その判定が使う条件 のどれかで のときと、付録 G.1 に書く場合である。 閾値は、どれも実験を流す前に決めた。 6 モデルのうちいくつが各結果になるかを示し、Llama-3.1-8B(§4.3 節)もほかのモデルと同じく数に入れ、Olmo-3 は別に示す。
4.3 value の入れ替え:答えはもう一方の人の色に変わるか(部分 (a))
[]
1 つの入力の中の入れ替えで言えること 書き換えた最初の層では、swap-V は の attention の重みを変えず、value を通してだけ に届き、それより後の層では、 の query も変わりうる。 もう 1 人の色は同じ文脈にあるので、答えがちょうどその色に変われば、value と key の組み合わせが答えを決めていることの証拠になる。 ただし色が 2 つだけだと、Alice の value の寄与が弱まっただけでも Bob の色が唯一の残る答えになりうるので、3 人の課題でこれを確かめる。 入れ替えには同じ長さの counterfactual な入力が要らないので、長い文書にも当てられる。
2 人 定型文の prompt では、6 モデルのうち Llama-3.1-8B を除くすべてで、swap-V は 98.3%--100.0%、swap-K は 84.2%--99.2% を与える(図 2、付録 F の表 7)。 6 モデルすべてで、swap-KV は を与え、key と value の両方の入れ替えに等しい位相の入れ替えは答えの分類をほとんど変えず( 98.3%--100.0%)、 を求める位相の基準を満たす(表 1)。
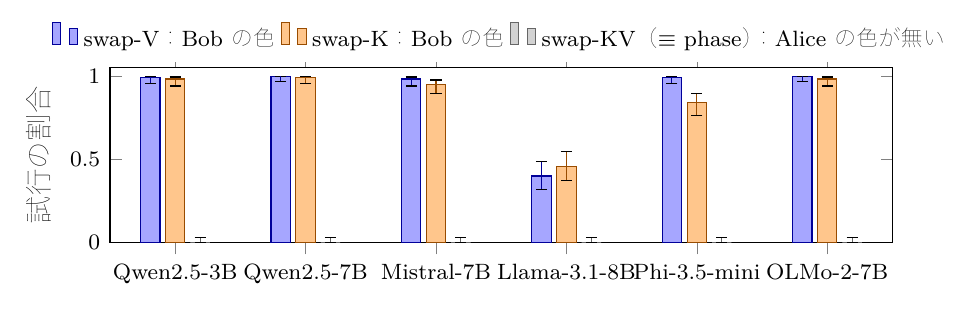
図2|定型文の prompt の短い文脈(各棒 試行)。 棒は、value の入れ替えと key の入れ替えのもとでの と、key と value の両方の入れ替えのもとでの を示し、後者は 6 モデルすべてで 0.000 である。 誤差の棒は Wilson の 95% 信頼区間を示し、数は表 7 に示す。
3 人 3 人の課題は Carol の色を足し、答えを、問われた人の色、入れ替えのもう 1 人の色、3 人目の色、 に分類する。 3 人では、Llama-3.1-8B 以外のどのモデルでも、Alice と Bob の value または key を入れ替えると、試行の 80% 以上で答えが Alice の色から Bob の色に変わるが、Bob と Carol の key を入れ替えても、Bob と Carol の色を 1 つの分類にまとめると、試行の 95% 以上で答えの分類は変わらない。 Llama-3.1-8B の判定は判定不能である(表 1)。
Llama-3.1-8B:事実の順への依存 Llama-3.1-8B では、定型文の prompt で swap-V と swap-K は 40.0% と 45.8% を与え、これは Alice の事実が先のときは 77.4% と 88.7%、Bob の事実が先のときはどちらも 0% である。 2 つの色を表す token のうち後ろのものの直後の位置から先で書き換えを読ませると、2 つの割合は 80.0% と 74.2% に上がる(付録 H.5)。
4.4 attention:問いの query は key で token を選ぶか(部分 (b))
選んだ head head は、書き換えなしで、評価の試行と重ならない 120 の選ぶための試行で選ぶ。 選んだ head は、Alice についての問いで選ぶための試行を平均したとき、prompt の最後の token から Alice の色を表す token への attention が、Bob の色を表す token への attention を 0.05 以上上回る query head である(付録 G.5)。
1 層の score これらの head が key の中身で token を選ぶかを確かめるため、選んだ各 head の層だけで key を入れ替える。 このとき、その層の query は書き換えなしと同じなので、その層での score の変化は key だけにより、動かした key の score の変化は RoPE の位相の変化だけによる。 書き換えなしでの 2 つの色を表す token の score の差の絶対値が 1 以上の(試行、層、選んだ head)の 3 つ組を考える。 そのうち、Alice の key の中身を Bob の位置へ動かしたとき、動かした key の attention の score の変化の絶対値が、この差の絶対値の半分以下である割合を 、Bob の key の中身について同じ割合を とする。 6 モデルすべてで、 0.935–1.000、 0.909–1.000 であり(表 8)、1 層の score の基準( かつ )を満たす(表 1)。 attention の重みは移した key の中身に付いて動くが(表 8、付録 H.2)、すべての層を書き換えると、読む層の query も変わる(付録 H.2)。
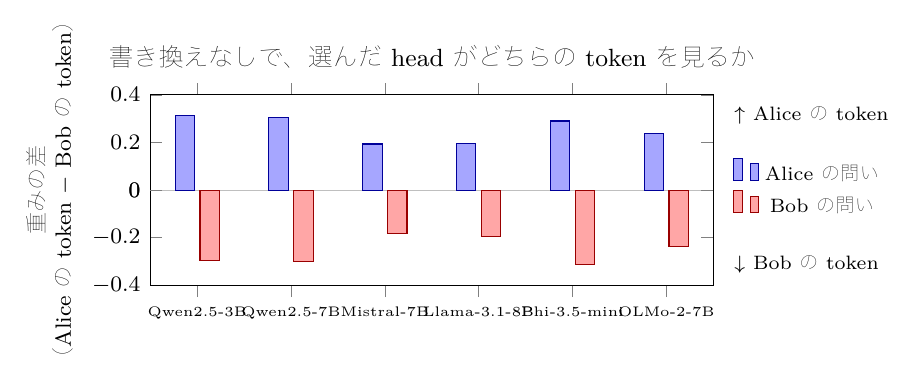
図3|書き換えなし、定型文の prompt での、prompt の最後の token からの選んだ head の attention。Alice の問いと Bob の問いのそれぞれで、Alice の色を表す token への重みから Bob の色を表す token への重みを引いた値()を、120 試行と選んだ head について平均した。 試行についての 95% bootstrap 信頼区間は より狭い(付録 C)。数は表 8 に示す。
Bob を問う head は Alice の問いで選んだので、Alice の問いで Alice の色を表す token を向くのは選び方から予想される。 「query が、問われた人の key を選ぶ」と「問いと関係なく Alice の key が選ばれやすい」を区別するため、"What is Bob's favorite color?" とも問う。 書き換えなしで、 と は、Alice についての問いと Bob についての問いで、選んだ head の Alice の色を表す token への attention の重みから Bob の色を表す token への重みを引いたものを、試行と head で平均したものである。 は、Bob についての問いで試行を平均したこの差が負になる、選んだ head の割合である。 6 モデルすべてで、選んだ head は、Alice の問いでは Alice の色を表す token に( 0.194–0.313)、Bob の問いでは Bob のその token に( は から 、図 3)多く重みを置く。 Bob の問いでは、試行で平均した重みは、選んだ head のどれでも Bob の token のほうが大きく()、Bob の問いでの attention の基準(、、)は 6 モデルすべてで満たされる(表 1)。
| モデル | 1 層の | Bob・ | 位相 | 3 人 | Bob・value | Bob・ |
| score | attention | の入れ替え | 3 人 | |||
| Qwen2.5-3B | ✓ | ✓ | ✓ | ✓ | ✓ | |
| Qwen2.5-7B | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Mistral-7B | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Llama-3.1-8B | ✓ | ✓ | ✓ | ? | ? | ? |
| Phi-3.5-mini | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OLMo-2-7B | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| 満たした数 | 6 | 6 | 6 | 5 | 4 | 5 |
表1|定型文の prompt での、表 2 の基準による判定(✓:満たす、:満たさない、?:判定不能)。物語の prompt でも、位相の基準は同じ判定になる。 mask と head ごとの knockout は付録 H.3にあり、6 モデルすべてで満たされる Bob の問いでの位相の基準は示していない。
問いの形:最後に出る名前 prompt の中で最後に出る名前はいつも問われた人の名前なので、これらの条件では、問いの意味で選ぶことと、その名前を手がかりに使うことを区別できない。 別の問いの形での対照は、問われた人と最後に出る名前を分ける:この対照は問いの文だけを 5 つの形のどれかに替え(表 10)、F2a と F2b では、もう 1 人の名前が問いの後に来る。 F2a と F2b でも、attention の重みを試行と同じ選んだ head で平均すると、6 モデルすべてと Olmo-3 で、それぞれの問いで問われた人の token のほうへ 0.05 以上偏る。 試行の 80% 以上で、選んだ head の平均は 2 つの問いの両方とも問われた人のほうへ偏る。 どのモデルのどの試行でも、2 つの問いの両方で最後に名前の出た人の token のほうを重く見ることはない(付録 H.2)。 基準(表 3)は、試行の 90% 以上で 2 つの問いの両方に正しく答えることも求め、Mistral-7B はこれに届かないので、基準を満たすのは、6 モデルのうち、判定不能の Mistral-7B を除くすべてと Olmo-3 である。
ほかの名前と属性 ほかの名前と属性での対照は、結果が Alice と Bob という名前と色に固有かどうかを確かめるもので、ほかの名前(S1)、ペット(S2)、朝の飲み物(S3)を使い、それぞれの設定で head を選び直す(付録 G.4)。 Bob の問いでの attention の基準は、どの組でも 6 モデルすべてと Olmo-3 で満たされる(表 9、付録 H.2)。 value の入れ替えの基準は、試行の 80% 以上で答えが Alice の属性の語から Bob の属性の語へ移ることを求める。 この基準を満たすのは、S1、S2、S3 で 6 モデルのうちそれぞれ 4、4、3 で、同じ実装と答えの分類で流し直した色の課題では 5 である(表 9、付録 H.1)。
4.5 2 つの部分をつなぐ:選んだ head が使う value
[]この節では、value の入れ替えが、選んだ head を通して答えを変えるかを問う。 選んだ head は、別の試行で Bob の色の token より Alice の色の token に attention を向けた query head である(§4.4 節)。 そこで、選んだ head が使う KV head の中だけで 2 つの色の token の value を入れ替え(、付録 G.6)、各層で同じ数の KV head を無作為に選んだ最大 10 の集合で入れ替えたものと比べる。 grouped-query attention では、multi-head attention と違い、 の外の query head もそれらの KV head を使う。
選んだ head が使う KV head の value だけを入れ替えると、答えが Bob の色に変わる試行の割合は Phi-3.5-mini で 98.3%、OLMo-2 で 100.0% である。 無作為な 10 個の集合では、どちらのモデルでもこの割合は多くても 3.3% である(表 13、基準は表 3)。 選んだ head が使う KV head が試行の 50% 以上で答えを変え、どの無作為な集合よりも 20 ポイント以上多く変えることを求める基準は、Phi-3.5-mini、OLMo-2、Olmo-3 で満たされ、Qwen2.5-7B では満たされず、Qwen2.5-3B、Mistral-7B、Llama-3.1-8B では判定不能である(付録 H.3)。 選ぶときの差が最も大きい head での head ごとの knockout は、その正の対照が満たされないので、6 モデルすべてで判定不能である(付録 H.3)。
4.6 長い文書
この節では、長い文書で key の入れ替えと value の入れ替えの効果が変わるかを問う。
文脈の長さ 物語の prompt の言い回しの 2 つの事実の文を Wikipedia の記事(WikiText-103 の 122 記事、[34])に入れ、約 1k・4k・16k token の文脈を作る。 約 1k token から最も長い長さまでの、key の入れ替えと value の入れ替えでの の下がり幅を 、 とする(付録 H.6 の表 14)。
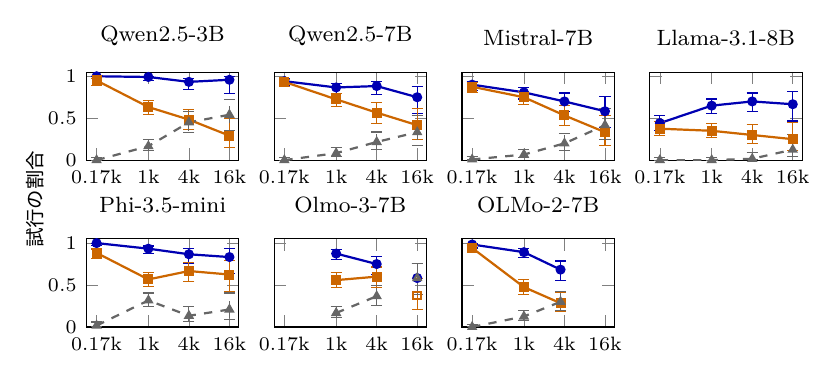
図4|7 モデルすべての約 1k・4k・16k token での結果:6 token の答えが Bob の色を含む(swap-V、swap-K)か、Alice の色を含まない(swap-KV。書き換えなしで含まない答えも含む)試行の割合。 いちばん左の点:物語の prompt の約 170 token の短い文脈(Olmo-3 は流していない)。ほかの点:Wikipedia の文書(OLMo-2 は約 1k と 3.5k token)。 白抜きの印:Olmo-3 で full attention の 8 層だけを書き換えた点。 誤差の棒:Wilson の 95% 区間。
約 1k token から最も長い長さへの 2 つの下がり幅の差()の 95% bootstrap 信頼区間は、Qwen2.5-3B と Mistral-7B では 0 を含まず、ほかの 5 モデルでは 0 を含む(図 4、表 14)。 ただし Mistral-7B、Phi-3.5-mini、Olmo-3、OLMo-2 では、長いほうの長さで書き換えなしの答えの 11.7%--33.3% が既に最初の 6 token に問われた色を含まないので、その下がり幅にはこれらの答えも入る(付録 H.6)。
key の入れ替えは value の入れ替えに位相の入れ替えを重ねたものと等しい(式 (7))ので、key の入れ替えでの大きな下がりは、2 つの key の中身ではなく RoPE の位相を入れ替えたことから来うる。 位相の入れ替えだけに等しい key と value の両方の入れ替えでも、書き換えなしで正答した試行の中で、長いほど答えが Bob の色に変わりやすい(下で述べる検証の前の予備の実験による表 5 の phase の列、付録 H.6)。
key を 1 つずつ動かす操作との比べ 位相の入れ替えは 2 つの動きを同時にする:Alice の key に Bob の位置の回転を、Bob の key に Alice の位置の回転を与える。 それぞれの動きを単独でしたときと比べるため、Alice の key だけに Bob の位置の回転を与える操作(shift-A)と、Bob の key だけに Alice の位置の回転を与える操作(shift-B)も流す。 上の約 1k・4k・16k token の文脈で予備の実験をすると、答えが Bob の色に変わる割合は、位相の入れ替えのほうが、shift-A と shift-B の割合を足したものより大きい(例えば Qwen2.5-3B の約 16k token では、0.542 に対して 0.083 と 0.250)。 どの書き換えでも答えが Bob の色に変わらなかった Llama-3.1-8B の約 1k・4k token を除き、すべてのモデルと長さでそうである(表 5、付録 D)。
長い文書での検証 この差は予備の実験で見つけたので、同じ記事から新しく作った 240 の文書で確かめた。 それぞれの文書は、約 3.5k と 16k token の prompt を、2 つの事実が近いときと遠いときについて与える(付録 D)。 検証には、図 4 のモデルから Phi-3.5-mini を除いたものを使い(付録 H.6)、これらのモデルの一部は 3 つの文脈の長さでの結果を理由に選んだので、結果はほかのモデルに当てはまらないかもしれない。 Olmo-3 では、予備の実験に合わせて、full attention の 8 層だけを書き換える。 予備の実験では、約 16k token で Alice の事実がほかの層の sliding window の外にある試行が多く、すべての層を書き換えると、書き換える層の数が試行と長さで変わっていた。 文書ごとの超過は、調べる長さの prompt のうち書き換えなしの答えが Alice の色を含み Bob の色を含まないものについて、位相の入れ替えで答えが Bob の色に変わる割合から、shift-A と shift-B での割合の和を引いた値を平均したものである。 超過の平均はすべてのモデルで正で、0.034(Olmo-3)から 0.283(Qwen2.5-7B)であり、その 95% bootstrap 区間は Olmo-3 を除くすべてのモデルで 0 を含まない(表 4)。 答えは 2 値なので、それぞれでは答えを変えない 2 つの操作が、合わせると答えを変えることがあり、この超過は 2 つの操作の相互作用を示さない。 logit の差のような連続の量は調べていない。
入れ替えずに 2 つの key を動かす この変化が、2 つの key の位置が入れ替わったことから来るのか、単に動いたことから来るのかを調べるため、同じ 240 の文書で、位相の入れ替えを、入れ替えずに同じ総量だけ動かす 2 つの移動と比べる(付録 D)。 2 つの色の語の token の距離を とし、平行な移動は 2 つの key を並びを保ったまま先頭の向きに だけ動かし、無作為な移動は前の key を 、後ろの key を だけ動かす。 と 2 つの符号は無作為に引く。 調べる長さでは、位相の入れ替えは、すべてのモデルで無作為な移動より多く答えを Bob の色に変える(平均の差は 0.037(Llama-3.1-8B)から 0.303(Qwen2.5-3B))。 また、Olmo-3 と OLMo-2 を除くすべてのモデルで、平行な移動より多く答えを変える。Olmo-3 と OLMo-2 の区間は 0 を含む(表 6)。 したがって、答えが変わるかは、key をどれだけ動かすかだけでなく、どこへ動かすかに依る。
長さと距離 短い文脈では、位相の入れ替えは答えの分類をほとんど変えない(§4.3 節)。これは、2 つの entity の位置を入れ替えても振る舞いはほとんど変わらないという Feng et al. [9] の報告と合う。 しかし調べる長さでは、調べたすべてのモデルで一部の prompt の答えを Bob の色に変え、2 つの事実が遠い Qwen2.5-3B では 235 中 230 の prompt で変える(付録 D)。 彼らの設定は、課題、書き換える token と位置、測る量(生成した答えではなく平均の log 確率)が私たちと違い、そのどれが結果の違いを生んだかは確かめていない。 同じ文書の中で、両方の設定で書き換えなしの答えが Alice の色を含み Bob の色を含まない prompt どうしを比べる。 位相の入れ替えは、両方の長さで調べたすべてのモデルで、約 3.5k より約 16k token で多く答えを Bob の色に変え、調べたすべてのモデルで、近いときより遠いときに多く変える。どちらも区間は 0 を含まない(表 4)。 どちらの比べも長さや距離だけを切り分けない:長い prompt は事実の前に中身の違う文も足し、前の事実を動かすと、入れ替える回転と、その事実から問いまでの距離も変わる。
Conclusion
同じ入力の 2 つの事実の cache の value を入れ替え、最後の位置だけに書き換えを読ませると、調べたモデルの多くで答えがもう一方の事実に変わった。 1 つの層の key を入れ替えたとき、選んだ head の attention は key の中身に従い、書き換えなしでは問いを変えると問われた事実へ移った。 一部のモデルでは、2 つの value をこれらの head が使う KV head の中だけで入れ替えると、同じ大きさの無作為な value の組を入れ替えるよりはるかに多く答えが変わった。 合わせると、これらの結果は、ある事実を指す key で呼び出される value が、その key が呼び出すべき事実を持つ、という主張を支持する。
これらの結果は、決まった型から作った短い prompt から得たものである。 長い文書では、2 つの key の RoPE の位相だけを入れ替えても、一部の試行で答えがもう一方の事実に変わった。 多くのモデルで、位相の入れ替えは、それぞれの位相を 1 つだけ動かしたときの割合の和より多く、答えをもう一方の事実に変えた。 長い文書では、query と key の照合が、答えを変えるほど key の RoPE の位相に依りうるが、調べた短い文脈では、位相の入れ替えが答えの分類を変えることはまれだった。 長い文書で、query がどの key を選ぶかに RoPE の位相がどう効くのかは、まだ分かっていない。 長い文書では答えしか記録していないので、そこで 2 つの事実の token への attention と、2 つの色の logit の差を測ることは今後の課題である。
限界 試行はどれも人物が 2 人か 3 人で属性が 1 つであり、もっと多くの人物や、自然に現れる事実は今後の課題とする。 色が 2 つだけだと、問われた事実の value を弱める入れ替えでも、もう一方の色が唯一の残る答えになりうる。 3 人の課題の結果はこの説明に反する証拠だが、3 人の課題は定型文の prompt でしか流していない。 value の入れ替えからは、value が色そのものを持つのか、Prakash et al. [3] の lookback の仕組みのように後の段階が色を取り出すのに使う番号を持つのかが分からない。
__REFERENCES__
Appendix
A. 実装の細部
書き換える key と value cache は、層 ・KV head ・位置 ごとに、RoPE を掛けた後の key と value を保存している。 私たちはこの cache の tensor を直接書き換える。 grouped-query attention [19] のモデル(Qwen2.5、Mistral、Llama)では、書き換えた KV head を使うすべての query head が書き換えを見る。 RoPE を掛ける前の key は として得る。 OLMo-2 と Olmo-3 では、key の射影の出力全体に RMSNorm [22] を掛けてから RoPE を掛けるので、 は正規化した後の key である。 ほかのモデルでは、 は key の射影の出力である。 Olmo-3 の full attention の層は RoPE を倍率つきで掛ける(YaRN)ので、 と は、各層の RoPE の写像とその逆を表す。 value には RoPE が掛からないので、そのまま動かす。
参考の書き換え patch-V は、2 人の色を入れ替えた counterfactual な入力の value で Alice の value を置き換えて、2 つの位置が同じ色を持つようにし、mask-A は Alice の色を表す token を位置 から先で mask する。
RoPE の精度 RoPE を外して掛け直すときはモデルの cos・sin の表を使い、モデルの通常の forward はこの表をモデルの dtype(bfloat16)に丸め、私たちの実装は float32 のまま使うこともできる。 結果を見る前に、2 つのやり方の間で swap-K と swap-KV の答えが定型文の prompt の 120 中 118 以上一致すれば float32 の値を示し、そうでなければモデルの dtype の値を示す、という手順を決めた。 5 モデルはこの手順の線を満たし、Llama-3.1-8B では swap-K の一致が 120 中 117(97.5%)なので、表 7 と表 12 は 2 種類の prompt ともモデルの dtype の値を示す。 長い文書での検証では、どのモデルでも float32 の表を使う。
実装の確かめ 丸め誤差を除けば等しい 4 組の書き換え(§3.2 節)は、 と書き換えなし、 と swap-V、swap-KV と phase、swap-K と である。 添字の raw は、RoPE を掛け直さずに key を動かすことを表す。 4 組は 4 モデルで完全に同じ答えになり、OLMo-2、Llama-3.1-8B、Olmo-3 では、答えが違って確かめ直した試行はどれも float32 で流し直すと一致したので、違いは bfloat16 の丸めと合う。
ソフトウェア どのモデルも bfloat16 で、Hugging Face の transformers [23] で動かし、生成は greedy である。 1 層の score、attention の重み、mask、head ごとの knockout、3 人の課題、Bob についての問い、ほかの問いの形・ほかの名前と属性・選んだ head が使う KV head の対照実験は、ライブラリの eager の attention と同じ演算をし、attention の score と重みも記録する私たち自身の attention の関数を使う。 ほかの条件はライブラリの scaled-dot-product attention を使う。 両方の実装で流した条件では、答えは、Qwen2.5-7B の dupK_BA(48.3%、付録 H.4)を除くどのモデル・条件でも、試行の 95.0% 以上で完全に一致する。 各組の一致、ほかの実装の確かめ、ライブラリの版と機械は補足資料に示す。
prompt と試行 各 prompt は、system の文を付けない 1 つの user の発話を、モデルの chat の template に通したものである。 Qwen2.5 の template は既定の system prompt を足し、Llama-3.1 の template は system の見出しを足す。 ほかのモデルの template は何も足さない。 user の発話は、"Read the following notes."(定型文の prompt)か "Read the following story."(物語の prompt)、空行、文脈、空行、"Question: " と問い、の順である。 試行は決まった seed で引く。 head を選ぶ試行は 101、長い文書での検証(付録 D)は 1、ほかのすべての評価の試行は 0 である。 長い文書は、WikiText-103(raw、[34])の test と validation の分割の記事から、red・blue・Alice・Bob・Carol・Dave の語を含む段落を除いて作る。 約 1k・4k・16k token の文脈では、無作為に選んだ始めの記事から、目標の長さに届くまで段落をつなぐ。 そのうえで、2 つの事実の文(それぞれ物語の prompt の 4 つの言い回しのどれか)を、文書の 2% から 98% の間で一様に引いた 2 つの別々の文の切れ目に入れ、user の発話は "Read the following document." にする。 長い文書での検証は、事実を独自のやり方で置く(付録 D)。
B. 判定の基準
位相の入れ替え、attention、key の複製、mask、head ごとの knockout、3 人の課題、Bob についての問いの基準(§4.2 節)を表 2 に示す。 どのモデルが満たすかは表 1 に示す。key の複製は 付録 H.4、mask・3 人の mask・head ごとの knockout は 付録 H.3 にあり、Bob の問いでの位相の基準は 6 モデルすべてで満たされる。 基準の中の量の式は 付録 G に示す。
| 基準 | 満たすとするのは |
|---|---|
| 位相 | かつ |
| 1 層の score | かつ |
| key の複製 | dupK_AB:。dupK_BA: |
| mask | swap-K の後、 を mask すると が 0.5 以上下がり、 を mask すると 0.1 以下しか下がらない(swap-V は位置を逆に) |
| head ごとの knockout | 正の対照を満たし、そのうえで を止めると が 0.3 以上下がり(bootstrap の区間が 0 未満)、各 より 0.2 以上多く下がり、もう一方の位置を止めても 0.1 以下しか変わらない |
| 3 人 | 。AliceBob の swap-V と swap-K で かつ 。BobCarol の swap-K で |
| 3 人・mask | swap-K の後、相手の位置を mask すると が 0.5 以上下がり、Carol の位置を mask すると 0.1 以下しか下がらない |
| Bob・value の入れ替え | (付録 G.4)のもとで、 かつ |
| Bob・位相 | のもとで、Bob の問いで かつ |
| Bob・3 人 | 3 人の試行での のもとで、BobAlice と BobCarol の value の入れ替えで試行の 0.8 以上が相手の色に移り、3 人目の色は 0.1 以下。位相の入れ替えで |
| Bob・attention | 、、(重みだけを使うので の条件は無い) |
表2|3 つの対照実験(表 3)以外の判定の基準。
3 つの対照実験(§4.4 節・§4.5 節)の基準を表 3 に示す。 ほかの名前と属性での対照の組 S1–S3 は、表 2 の基準をそれぞれの前提の条件とともにそのまま使い、value の入れ替えの基準を加える。 判定の結果は、構成、前提の条件、 の条件、基準の順に決めるので、前提の条件と の条件の両方が満たされないときは前提の条件のほうを示す。
| 基準 | 満たすとするのは |
|---|---|
| 問いの形・問われた人 | 、、 |
| 問いの形・最後の人 | 、、( の条件は無いが、 の門は当てる) |
| 問いの形・value の入れ替え | 2 つの問い のどちらでも、 かつ 。qu は問われた人、pa はもう 1 人 |
| 問いの形・位相 | 2 つの問いのどちらでも、 |
| value の入れ替え(S1–S3) | のもとで、 かつ |
| 選んだ head の KV head | かつ のもとで、 かつ 。 なら構成上判定不能 |
| 選んだ head の KV head・3 人 | 上と同じで、3 人の課題を使い、mv の代わりに 、最初の 個の無作為な集合を使い、 も求める |
| 選んだ head の KV head・ | 「選んだ head の KV head」と同じで、 の代わりに と、それ自身の無作為な集合を使う |
表3|3 つの対照実験の判定の基準。問いの形の基準は F2a と F2b の両方で成り立つことを求め、断りの無い限り、 の形だけを使う(付録 G.4)。
C. 区間と閾値の感度
断りの無い限り、区間は、試行を 10,000 回 resample した 95% の percentile bootstrap 信頼区間である。 head と(試行、head)の組は、独立な単位として resample しない。 約 1k・4k・16k token の 3 つの長さは同じ seed で作ったので、試行 は長さの間で対応する。 3 つの長さすべてで流したモデルでは、試行 – はどの長さにも、– は約 1k と 4k に、– は約 1k だけにある。 そのため試行はこの 3 つの層の中で resample し、それらを含むすべての長さと条件に同じ引き方を使うので、同じ試行で測った条件は対のまま保たれる。 短い文脈は別に resample する。 長い文書はどれも 122 の Wikipedia の記事から作り、段落は試行の間で重なる(約 16k token の文脈では、文書の段落の平均 50.6% がほかの文書にも現れる)ので、区間はこれらの記事を条件とする。
統計の範囲 図 2 と図 4 には Wilson の 95% 信頼区間 [24] を示す。 McNemar の正確な検定 [25] で、判定不能だった head ごとの knockout の判定の bootstrap [26] 区間を確かめ直し、変わった判定は無い。 bootstrap 区間は、生成、head の選び方、基準の選び方によるばらつきを含まない。
文脈の長さ 表 14 に 、、 の区間を示す。 短い文脈から約 16k token への、付録 H.6 の下がり幅は、Qwen2.5-3B の value の入れ替え(4.2 [0.0, 12.5] ポイント)を除き、どれも区間が 0 を含まない。 Qwen2.5-3B の key の入れ替えでの下がり幅は 65.8 [46.7, 83.3] ポイントである。
満たした判定の余裕 表 2 の基準による満たした判定のそれぞれについて、余裕は各統計量の閾値からの距離である。 多くの余裕は区間が 0 を含まない。 例外は key の複製の判定である。 Qwen2.5-7B の dupK_BA では、余裕は 0.0 [, 8.3] ポイントである。 の条件も含めて判定全体を resample ごとに計算し直すと、resample の 45.3% で満たし、42.8% で満たさず、11.9% で判定不能になる。 dupK_AB では、余裕の区間は、物語の prompt の Qwen2.5-3B と OLMo-2 で 0 を含み、定型文の prompt の Qwen2.5-3B で 0 に触れる。
閾値の感度 表 2 の基準による判定で、各閾値を、その統計量の取りうる範囲の中で 1 つずつ と だけ動かし、 の条件を 5% と 15% に動かした。 key の複製の判定のほかに、3 人・mask の判定が Qwen2.5-3B・Phi-3.5-mini・OLMo-2 で満たさなくなり Qwen2.5-7B で満たすようになり、Qwen2.5-3B の Bob の問いでの value の入れ替えが満たすようになる。 Phi-3.5-mini では、物語の prompt での位相の基準と 3 人の判定が満たさなくなり、head ごとの knockout は判定不能から満たさないに変わる。 ほかの判定は変わらない。
attention ( について)とする。 どのモデルでも、120 試行のすべてで かつ である。 と の区間は点の値から 0.008 以内にある。 への余裕がいちばん小さいのは Mistral-7B の で、 [, ] である。 と の区間でいちばん広いのは Phi-3.5-mini の で、0.285 [0.269, 0.301] である。
対照実験 3 つの対照実験の区間も、同じ bootstrap で計算する。 評価の試行の resample は 1 回にし、その試行で測ったすべての形・問い・条件で共有する。 S2 と S3 の試行と、3 人の課題の試行は、別に resample する。 swap-V@ での対照の区間は、引いた無作為な集合を条件とする。 同じ動かし方を構成上の閾値 1/2 にも当てた。 構成上の閾値を 0.45 にすると、Qwen2.5-7B の 3 人での swap-V@ の判定は構成上判定不能になり、0.60 にすると、Qwen2.5-3B の の判定は、構成上判定不能から満たさないに変わる。
D. 長い文書での検証
試行 §4.6 節の 240 の文書 ごとに、同じ 122 記事から始めの記事を 1 つ一様に、復元抽出で引き、その記事と、決まった順でそれに続く記事(最後まで行けば最初に戻る)の段落を、文書が 70,000 文字以上になるまでつなぐ。 後の事実の文は、末尾から 2,200 文字前にいちばん近い文の境目に入れ、前の事実の文は、後の事実から 1,100 文字(近い)か 8,800 文字(遠い)前にいちばん近い境目に入れる。 Alice の色と、どちらの事実が後に来るかは、それぞれ確率 1/2 で引く。 記事・色・順・各事実の言い回しは文書ごとに独立に引くので、文書は独立で同じ分布に従う(i.i.d.)。 長い prompt は文書全体(14,301–18,916 token)、短い prompt は、段落の境目から始まり 15,500 文字以上ある、文書の最後の部分のうちいちばん短いもの(3,234–4,947 token)である。 こうして文書ごとに、長さと距離の組み合わせごとに 1 つ、計 4 つの prompt ができる。 同じ距離での短い prompt と長い prompt は、事実、事実の間の文、事実の後の文、問いを共有する。 同じ長さでの近い prompt と遠い prompt の間で違うのは前の事実の場所だけである。 後の色を表す token は、prompt の最後の token の 252–838 token 前にある。 OLMo-2 では、最大の長さより長い 4 つの prompt は流していない。
書き換えと答えの変化 prompt について、 と を Alice と Bob の色を表す token の位置、 をその key の中身とする。 下の書き換えはどれもすべての層と KV head で行い、prompt の最後の token から先で読ませる。 ただし Olmo-3 では、予備の実験と同じく full attention の 8 層だけを書き換える。 phase(§3.2 節)のほかに、一方の key だけを動かす 2 つの操作
と、そのずらした版 と ( について)を使う。 ずらした版は代わりに と へ回すので、2 つの key が同じ RoPE の位置を共有することはない。 value は変えない。 モデル 、書き換え 、prompt について、 を、 のもとでの答えの最初の 6 token が、小文字にして Alice の色を部分文字列として含めば 1 とし、 を Bob の色について同じように定める。 を書き換えなしで Alice の色だけで答えた prompt とし、( について)とする。答えが Bob の色だけに変われば 1 である。 数値の誤差の確かめとして、すべての長さと距離にわたる の prompt のうち、丸め誤差を除けば位相の入れ替えと等しい key と value の両方の入れ替えが、位相の入れ替えと同じ を与える prompt の数も数える(表 4 の列「一致」)。 調べる長さ は約 16k token で、文脈の長さが 4,096 token の OLMo-2 では約 3.5k である。 を、 での文書 の近い prompt と遠い prompt のうち に入るもの、 とする。 について、
長さと距離の比較では、 を長さ 、距離 での文書 の prompt とする。 を両方の長さが に入る距離、 を両方の距離が に入る長さとして、
区間 文書は i.i.d. であり、 かどうかは文書 だけで決まるので、 の は i.i.d. である。下のほかの量も同じである。 どの量についても、文書についての平均と、文書を引き直す 2,000 回の bootstrap による 95% percentile 区間を示す。 比べる prompt を、書き換えなしの答えが Alice の色を含み Bob の色を含まない の prompt に限ったことの影響は調べていない。
| モデル | 平均 | 区間 | 平均 | 区間 | 平均 | 区間 | 平均 | 区間 | 一致 | |
| Qwen2.5-3B | 238 | 0.267 | [0.206, 0.326] | 0.271 | [0.212, 0.329] | 0.097 | [0.067, 0.126] | 0.839 | [0.799, 0.877] | 941/943 |
| Qwen2.5-7B | 237 | 0.283 | [0.243, 0.323] | 0.287 | [0.247, 0.329] | 0.251 | [0.217, 0.285] | 0.464 | [0.418, 0.511] | 942/944 |
| Mistral-7B | 235 | 0.145 | [0.102, 0.187] | 0.143 | [0.101, 0.184] | 0.103 | [0.068, 0.141] | 0.268 | [0.223, 0.318] | 902/903 |
| Llama-3.1-8B | 240 | 0.037 | [0.015, 0.065] | 0.036 | [0.014, 0.062] | 0.056 | [0.033, 0.081] | 0.019 | [0.002, 0.037] | 959/960 |
| Olmo-3-7B | 221 | 0.034 | [0.000, 0.068] | 0.025 | [, 0.058] | 0.046 | [0.011, 0.083] | 0.096 | [0.055, 0.139] | 814/817 |
| OLMo-2-7B | 230 | 0.102 | [0.061, 0.148] | 0.111 | [0.072, 0.154] | --- | --- | 0.188 | [0.126, 0.256] | 434/437 |
表4|長い文書での検証(付録 D):文書についての平均と 95% bootstrap 区間。 : に入る prompt を持つ文書の数。 一致:書き換えなしで Alice の色だけで答えた prompt のうち、key と value の両方の入れ替えと位相の入れ替えで、答えが Bob の色に変わるかどうかが一致する prompt の数。 約 3.5k token。長さの比べには入らない。
| モデル | 試行(約 1k、4k、16k token) | phase |
shift-A |
shift-B |
|---|---|---|---|---|
| Qwen2.5-3B | 120, 59, 24 | 0.142, 0.407, 0.542 | 0.000, 0.051, 0.083 | 0.017, 0.051, 0.250 |
| Qwen2.5-7B | 119, 60, 24 | 0.050, 0.183, 0.333 | 0.000, 0.000, 0.042 | 0.000, 0.017, 0.042 |
| Mistral-7B | 115, 55, 20 | 0.026, 0.127, 0.300 | 0.000, 0.018, 0.100 | 0.017, 0.055, 0.150 |
| Llama-3.1-8B | 120, 59, 23 | 0.000, 0.000, 0.087 | 0.000, 0.000, 0.000 | 0.000, 0.000, 0.000 |
| Olmo-3-7B | 118, 50, 16 | 0.025, 0.060, 0.375 | 0.008, 0.020, 0.125 | 0.000, 0.000, 0.062 |
| OLMo-2-7B | 119, 53 | 0.118, 0.208 | 0.008, 0.038 | 0.050, 0.094 |
表5|3 つの文脈の長さの試行での予備の実験:書き換えなしの答えが Alice の色を含み Bob の色を含まない試行についての、位相の入れ替えと、shift-A と shift-B で答えが Bob の色に変わる割合。検定はしていない。 Olmo-3:full attention の 8 層だけを書き換え、3 つの書き換えが同じ層を変える試行だけを含める。約 1k と 3.5k token。
予備の実験 表 5 の、割合が 0 でない 15 の(モデル、長さ)の組のどれでも、位相の入れ替えは、shift-A と shift-B を合わせたより多く答えを Bob の色に変える。 15 組のうち 5 組では、その差は 1〜2 試行だけである。
shift-A と shift-B のずらした版 動かした key がもう一方の key と同じ回転の位置を持たない版 (式 (11))でも、 と同じ結果になり、区間は Olmo-3 を除くすべてのモデルで 0 を含まない(表 4)。 すべての長さと距離にわたって、一方の key だけを動かす操作(shift-A か shift-B)の割合と、そのずらした版のどちらかの割合との差の最大値は、モデルによって 0.4 から 1.6 ポイントの間にある。
位相の入れ替えでの答えの変化 調べる長さで、書き換えなしで Alice の色だけで答えた prompt のうち、位相の入れ替えで答えが Bob の色に変わる割合は 2.3%(Mistral-7B、近い)から 97.9%(Qwen2.5-3B、遠い)までで、どのモデルと距離でも正である。
入れ替えずに 2 つの key を動かす prompt について、、、 とする。 移動 は、 の key を、その key の中身に を掛けたものに置き換える。層と KV head は上と同じで、prompt の最後の token から後ろに読ませる。 の key は変えない。 位相の入れ替えは 、平行な移動は 、無作為な移動は である。 と は prompt ごとに 1 回、一様かつ独立に引き、動かした 2 つの key がともに に入るまで引き直す。 は prompt の token の数である。 について、
とする。rnd は無作為な移動を表す。 は平行な移動で同じように定め、 のうち動かした 2 つの key がともに に入る prompt の上で平均し(OLMo-2 は近い prompt だけ)、その prompt が 1 つ以上ある文書について定める。 平均と区間は と同じように求める。 表 6 の区間は、文書を 2,000 回引き直す bootstrap のパーセンタイル区間である。
| モデル | 文書 | 平均 | 区間 | 遠い | 近い | 平均 | 区間 |
| Qwen2.5-3B | 238 | 0.303 | [0.265, 0.340] | 0.587 | 0.017 | 0.210 | [0.166, 0.252] |
| Qwen2.5-7B | 237 | 0.257 | [0.222, 0.295] | 0.509 | 0.013 | 0.184 | [0.143, 0.226] |
| Mistral-7B | 235 | 0.136 | [0.102, 0.174] | 0.274 | 0.145 | [0.113, 0.179] | |
| Llama-3.1-8B | 240 | 0.037 | [0.017, 0.060] | 0.050 | 0.025 | 0.029 | [0.015, 0.048] |
| Olmo-3-7B | 221 | 0.068 | [0.038, 0.102] | 0.064 | 0.034 | 0.020 | [, 0.052] |
| OLMo-2-7B | 230 | 0.065 | [0.026, 0.104] | 0.088 | 0.041 | 0.018 | [, 0.059] |
表6|調べる長さでの、位相の入れ替えと無作為な移動・平行な移動との比べ(付録 D): と の文書の上の平均と 95% bootstrap 区間。 遠い・近い:その距離の prompt の上で平均した 。 約 3.5k token。 は近い prompt だけを使う(220 文書)。
E. 試行の例
定型文の prompt の 1 番目の試行(、seed 0)の user の文を下に示す。 書き換える 2 つの token に下線を引いた。 この文の周りに、モデルの chat の template を当てる。
Read the following notes.
The hiking trail is closed after heavy storms. A local band will perform in the park this weekend. The bridge on the main road is being repaired. The meeting was moved to the second floor conference room. Alice's favorite color is [blue]{.underline}. A long queue formed outside the ticket office. A new bakery started selling bread near the station last month. The museum added a small exhibit about old clocks. Bob's favorite color is [red]{.underline}. The library opens at nine in the morning on weekdays.
Question: What is Alice's favorite color? Answer with one word.
F. 主な結果の表
表 9 の value の入れ替えの基準は、表 3 のものである。
| モデル | none | mask-A | patch-V | swap-V | swap-K | swap-KV |
|---|---|---|---|---|---|---|
| Qwen2.5-3B | 1.000 | 0.000 | 0.000 | 0.008 | 0.017 | 1.000 |
| Qwen2.5-7B | 1.000 | 0.350 | 0.000 | 0.000 | 0.008 | 1.000 |
| Mistral-7B | 1.000 | 0.000 | 0.000 | 0.000 | 0.017 | 1.000 |
| Llama-3.1-8B | 1.000 | 1.000 | 0.000 | 0.600 | 0.542 | 1.000 |
| Phi-3.5-mini | 1.000 | 0.008 | 0.000 | 0.008 | 0.158 | 1.000 |
| OLMo-2-7B | 1.000 | 0.442 | 0.000 | 0.000 | 0.017 | 1.000 |
| Qwen2.5-3B | 0.000 | 1.000 | 1.000 | 0.992 | 0.983 | 0.000 |
| Qwen2.5-7B | 0.000 | 0.650 | 1.000 | 1.000 | 0.992 | 0.000 |
| Mistral-7B | 0.000 | 0.008 | 1.000 | 0.983 | 0.950 | 0.000 |
| Llama-3.1-8B | 0.000 | 0.000 | 1.000 | 0.400 | 0.458 | 0.000 |
| Phi-3.5-mini | 0.000 | 0.992 | 1.000 | 0.992 | 0.842 | 0.000 |
| OLMo-2-7B | 0.000 | 0.367 | 1.000 | 1.000 | 0.983 | 0.000 |
表7|定型文の prompt で答えが Alice の色を含む試行の割合()と Bob の色を含む試行の割合()(図 2)。全層・全 KV head を書き換え、prompt の最後の token から後(生成する token を含む)で書き換えを読ませる。。
| 1 つの層の key の入れ替え | key の複製 | 書き換えなし | ||||||
| モデル | dupK_AB |
(dupK_BA) |
||||||
| Qwen2.5-3B | 0.991 | 0.991 | 0.294 | 0.275 | 0.717 | 0.313 | ||
| Qwen2.5-7B | 0.998 | 0.998 | 0.290 | 0.000 | 0.500 | 0.305 | ||
| Mistral-7B | 0.994 | 0.998 | 0.191 | 0.008 | 0.000(すべて amb) | 0.194 | ||
| Llama-3.1-8B | 1.000 | 1.000 | 0.189 | 0.000 | 0.958 | 0.194 | ||
| Phi-3.5-mini | 0.935 | 0.909 | 0.285 | 0.333 | 0.783 | 0.290 | ||
| OLMo-2-7B | 0.999 | 0.999 | 0.228 | 0.467 | 0.583 | 0.237 |
| query の比 | 比 | ||||||
| モデル | cov. | swap-K |
swap-V |
swap-K |
swap-V |
||
| Qwen2.5-3B | 0.946 | 0.936 | 0.553 | 0.205 | 0.190 | 0.227 | 0.215 |
| Qwen2.5-7B | 0.921 | 0.900 | 0.740 | 0.187 | 0.190 | 0.163 | 0.162 |
| Mistral-7B | 0.883 | 0.872 | 0.792 | 0.109 | 0.108 | 0.150 | 0.154 |
| Llama-3.1-8B | 0.915 | 0.686 | 0.381 | 0.425 | 0.424 | 0.456 | 0.442 |
| Phi-3.5-mini | 0.816 | 0.754 | 0.587 | 0.207 | 0.225 | 0.247 | 0.278 |
| OLMo-2-7B | 0.936 | 0.897 | 0.612 | 0.124 | 0.122 | 0.233 | 0.237 |
表8|定型文の prompt での attention の量と key の複製の結果(表 1、付録 H.4)。 dupK_AB:Alice の色から外れた試行の割合。: に対して。答えがすべて のときは「すべて amb」。 下の段(付録 H.2):cov. :3 つ組のうち に入る割合。:全層の key の入れ替えでの 。全層の入れ替えの後の query の比。
| 色 | S1 | S2 | S3 | ||||||||||
| 基準 | 元 | 満 | 否 | 不 | 満 | 否 | 不 | 満 | 否 | 不 | 満 | 否 | 不 |
| value の入れ替え | -- | 5 | 0 | 1 | 4 | 1 | 1 | 4 | 1 | 1 | 3 | 1 | 2 |
| 位相 | 6 | 6 | 0 | 0 | 6 | 0 | 0 | 6 | 0 | 0 | 6 | 0 | 0 |
dupK_AB |
3 | 3 | 3 | 0 | 3 | 3 | 0 | 0 | 6 | 0 | 0 | 6 | 0 |
dupK_BA |
1 | 0 | 4 | 2 | 0 | 4 | 2 | 0 | 2 | 4 | 0 | 2 | 4 |
| Bob・value の入れ替え | 4 | 4 | 1 | 1 | 5 | 0 | 1 | 5 | 1 | 0 | 3 | 1 | 2 |
| Bob・位相 | 6 | 6 | 0 | 0 | 6 | 0 | 0 | 6 | 0 | 0 | 5 | 0 | 1 |
| Bob・attention | 6 | 6 | 0 | 0 | 6 | 0 | 0 | 6 | 0 | 0 | 6 | 0 | 0 |
| Bob・3 人 | 5 | -- | -- | 5 | 1 | 0 | 4 | 0 | 2 | ||||
| 3 人 | 5 | -- | -- | 5 | 1 | 0 | 3 | 1 | 2 |
| 基準 | 元 | 色 | S1 | S2 | S3 |
|---|---|---|---|---|---|
| value の入れ替え | -- | ✓ | ✓ | ✓ | |
| 位相 | ✓ | ✓ | ✓ | ✓ | ✓ |
dupK_AB |
✓ | ✓ | |||
dupK_BA |
? | ? | ? | ? | ? |
| Bob・value の入れ替え | ✓ | ✓ | ✓ | ✓ | |
| Bob・位相 | ✓ | ✓ | ✓ | ✓ | ✓ |
| Bob・attention | ✓ | ✓ | ✓ | ✓ | ✓ |
| Bob・3 人 | ✓ | -- | -- | ✓ | |
| 3 人 | ✓ | -- | -- | ✓ |
表9|ほかの名前と属性での対照の判定:表 2 の基準を、ほかの名前(S1)、ペット(S2)、飲み物(S3)で当てた結果。 上の段:6 モデルのうち、満たす(満)、満たさない(否)、判定不能(不)になったモデルの数。元:元の色の課題で満たすモデルの数(表 1、付録 H.4)。色:S1–S3 と同じく流し直した色の課題。 下の段:Olmo-3-7B(✓:満たす、:満たさない、?:判定不能)。
G. 方法の細部
G.1 課題と評価の細部
prompt は、定型文の prompt で約 115–150 token、物語の prompt で約 145–180 token である。
答えの分類 §4.2 節の答えの分類では、6 token で切れた答えを 16 token に延ばす。 答えを小文字にし、前後の空白・引用符・アステリスクと、最後のピリオドか感嘆符を除く。 色だけ、または前に "Name's favorite color is"(名前は問われた人)、"her favorite color is"、"the answer is"、"answer:" のどれかが付いた色だけのときに限り、Alice の色(A)か Bob の色(B)に分類し、それ以外は とする。 Bob を問う条件と、それと並べて流した Alice の問いでは、どちらの問いでも代名詞の前置きを受け付けないので、これらの条件での答えの分類は別に示す。 に分類した答えは、人の目で確かめ直していない。
答えの分類での量 条件 の下での試行 の答えの分類を と書く。 次のように定める。
また、 とする。
判定不能の判定 前提の条件を満たさない判定と、構成上判定不能になる swap-V@ の判定(付録 G.6)も、判定不能として示す(付録 B)。
共通の設定 答えの分類を使う測定(§4.2 節)は、式 (5) の位相の入れ替えも流す。 3 人の課題とほかの名前と属性での対照を除き、これらの測定は同じ定型文の prompt の 120 試行を使い、2 人の入れ替え・位相の入れ替え・key の複製は物語の prompt でも流す。 3 つの対照実験は、Bob を問う条件と同じく、代名詞の前置きを受け付けない答えの分類を使う。
G.2 各書き換えの下の cache の組
図 5 に、§3.2 節の等価が比べる(key、value)の組を示す。
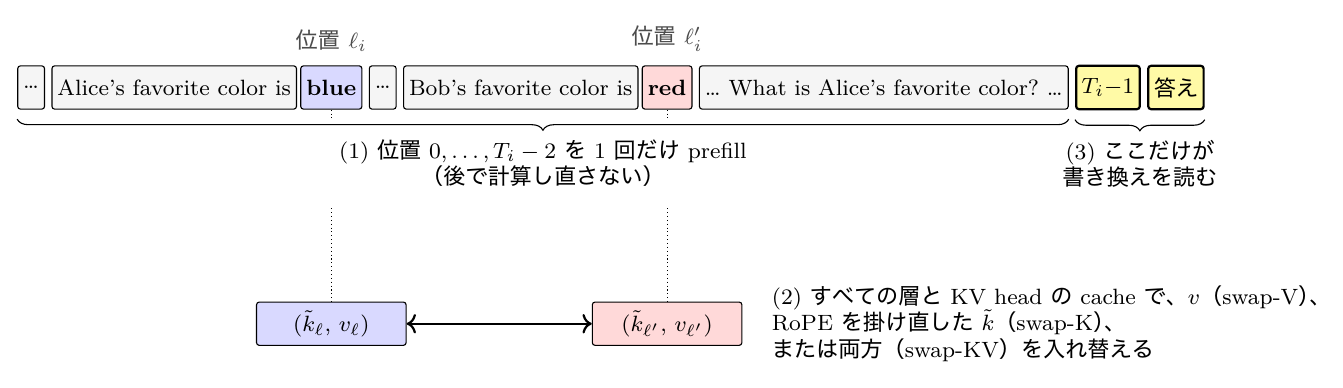
図5|1 つの層・1 つの KV head での、各書き換えの下の 2 つの色の語の token の位置の cache の(key、value)の組。 は RoPE を掛ける前の key、 は位置 の回転。 最後の行は、Bob の key の中身を Alice の位置に写す である(付録 G.3)。
G.3 key の複製
key の入れ替えは value の入れ替えから独立した証拠にならないので(§3.2 節)、key の複製も 2 つ流した。 §3.2 節の を使い、すべての層と KV head に当て、value は変えない key の複製を、次のように定める:
dupK は、2 つの位置に同じ key の中身と違う value を置くので、組のどんな並べ替えでも作れない。 基準は表 2、結果は付録 H.4にある。
G.4 課題を変えた条件と問いの形
3 人 3 人の課題は、Alice・Bob・Carol の色(すべて違う)を無作為な順で述べ、Alice の色を問う。 色は blue・red・green で、どれも 6 つの tokenizer のすべてで 1 token になる。 答えは、問われた人の色(self)、入れ替えのもう 1 人の色(part)、3 人目の色(oth)、 に分類する。 入れ替えは、Alice と Bob、または Bob と Carol の色を表す token の位置の間で行う。 BobCarol の入れ替えでは Bob と Carol の色を 1 つの分類にまとめるので、そこでの は、答えが Alice の色とほかの色との区別を保つかを確かめる。
Bob を問う問い 問い での試行 の答えの分類を (§4.2 節)とする。 2 つの問いを使う、答えにもとづく基準は、前提の条件として、書き換えなしで同じ試行で 2 つの問いの両方に正しく答える試行が 90% 以上であることを求める。 ここで
で、A と B は Alice と Bob の色である。3 人の課題では、 を 3 人の試行で同じように計算する。問いの形 (下で述べる)では、これを と書く。
問いの形 問いの形(表 10)は 120 の評価の試行の文脈をそのまま使い、prompt の最後の token は、どの形でも同じ chat の template の token である。
| 形 | 問いの文 | 最後に出る人名 |
|---|---|---|
| F0 | What is 's favorite color? | |
| F1a | would like to know: what is 's favorite color? | |
| F1b | (Question from .) What is 's favorite color? | |
| F2a | What is 's favorite color? would like to know. | |
| F2b | What is 's favorite color? (Question from .) |
表10|5 つの問いの形。:問われた人、:もう 1 人。どの形も最後は "Answer with one word." である。
ほかの名前と属性 3 つの組で、表 2 の判定を繰り返す。 S1 では、評価の試行と head を選ぶための試行(§4.4 節)の名前だけを、試行ごとに、どの tokenizer でも 1 token になる 29 の名前の一覧から引いた 2 つの名前に替える。 S2(ペット)と S3(朝の飲み物)は、事実の文、中立な文、色の代わりに入る属性の語も替える。 事実の文は "Name has a X as a pet." と "Name usually drinks X in the morning."(X は属性の語)で、問いは "Which animal does Name keep as a pet?" と "What does Name usually drink in the morning?" の後に "Reply with a single word." を続けたものである。 2 人(または 3 人)の属性の語は、属性ごとに 5 つの中から引いた別々の語なので、色が 2 つの場合と違い、もう 1 人の属性の語は問われた人の属性の語から決まらない。 S2 と S3 の答えの分類は、S2 の複数形など、課題ごとの形も認める。 この分類は、評価の試行を見る前に、組ごとに別の 20 試行で決め、語の一覧と分類の規則はコードとともに公開する。 S2 と S3 には 3 人の課題もある。 各組で、同じ規則により、別の 120 試行で head を選び直す。 比較のために、同じ実装と答えの分類で、Alice の問いと表 2 の主な条件について、色の課題も流し直す。
G.5 attention の細部
式 層 と、KV head を使う query head について、 を attention の score、 を位置 から 、 への attention の重みとする。 120 の選ぶための試行(§4.4 節、添字 )で選ぶと、6 モデルのそれぞれで 35–53 個(Olmo-3 では 58 個)の head が選ばれる:
層 だけに当てた書き換え を と書く。 上付きの を省き、書き換えなしの score の差 と、同じ key の中身をもう一方の位置へ動かしたことによる score の変化 を、次のように定める:
を使い、 について
と定める。 また、すべての試行と選んだ head について、重みの変化を
とする。 書き換えなしで、次のように定める(、 について)。
どの形と問いでも同じ を使い、次のように定める( について)。
の下では層 の query は変わらないので、丸め誤差を除けば
であり、 も同様なので、 は RoPE の位相だけによる。
記録と、すべての層での書き換え score は causal mask の前に float32 で記録する。 書き換え について、すべての層での書き換えを と書く。 すべての層を書き換えた後で同じ測定を繰り返すと、層 の query 自身がどれだけ変わるかが分かる:位置 の key は同じなので、 は query だけによる。
G.6 選んだ head が使う KV head、head ごとの knockout
層 の KV head を と書き、 を全 KV head の集合とする。選んだ head が使う KV head を として、 について
とし、ほかの KV head はどれも変えない。 各モデル で、swap-V@ での対照は 個の無作為な KV head の集合 ()を引き、どの層でも、各集合は と同じ数の KV head を、その層の KV head から一様に無作為に引いて持つ。 無作為な集合は と重なってよいが、 と等しくはしない。 選んだ head が使うものを除くすべての KV head を入れ替える も流す。 Alice の問いで とし、表 3 の基準はこれを使う。 すべての無作為な集合が共有する の KV head が の半分以上になるときは、KV head の少ないモデルで起きるように、無作為な集合が選んだ集合の多くを共有するので、その判定は構成上判定不能とする。
head ごとの knockout(付録 H.3)は、層の範囲のすべての head を止める Geva et al. [11] の attention knockout を、1 つの head の集合に限ったものである。 色を表す位置を最後の位置から隠すのは、 か、層ごとに と同じ数の head を持つ 3 つの無作為な head の集合 ()のどれかである。 は、 の大きい順に、 の半分に届くまで、各層の head の半分を上限として head を取って作り、モデルごとに 10–17 個になる。 正の対照は、書き換えなしで を止めると が 30 ポイント以上下がることを求める。
G.7 モデル
表 11 に、6 つのモデルと、線の下に Olmo-3-7B-Instruct を示す。 Olmo-3-7B-Instruct の sliding window の層(窓 4096 token)は、短い文脈では prompt 全体を見る。
| モデル | 識別子 | ||||
|---|---|---|---|---|---|
| Qwen2.5-3B [27] | Qwen/Qwen2.5-3B-Instruct |
36 | 16 | 2 | 128 |
| Qwen2.5-7B [27] | Qwen/Qwen2.5-7B-Instruct |
28 | 28 | 4 | 128 |
| Mistral-7B [28] | mistralai/Mistral-7B-Instruct-v0.3 |
32 | 32 | 8 | 128 |
| Llama-3.1-8B [29] | meta-llama/Llama-3.1-8B-Instruct |
32 | 32 | 8 | 128 |
| Phi-3.5-mini [30] | microsoft/Phi-3.5-mini-instruct |
32 | 32 | 32 | 96 |
| OLMo-2-7B [31] | allenai/OLMo-2-1124-7B-Instruct |
32 | 32 | 32 | 128 |
| Olmo-3-7B [32] | allenai/Olmo-3-7B-Instruct |
32 | 32 | 32 | 128 |
表11|モデル(Hugging Face の識別子)。:層の数、・:query head と KV head の数、:head の次元。
H. 結果の詳細
H.1 value の入れ替え:物語の prompt、3 人、その他の細部
物語の prompt 物語の prompt(表 12)では、swap-V と swap-K は 6 モデルのうち Llama-3.1-8B を除くすべてで 87.5%--100.0% の試行で Bob の色を、swap-KV は 6 モデルすべてで 98.3%--100.0% の試行で Alice の色を答えさせる。
| モデル | none | mask-A | patch-V | swap-V | swap-K | swap-KV |
|---|---|---|---|---|---|---|
| Qwen2.5-3B | 1.000 | 0.267 | 0.000 | 0.000 | 0.050 | 1.000 |
| Qwen2.5-7B | 1.000 | 0.342 | 0.017 | 0.008 | 0.017 | 1.000 |
| Mistral-7B | 0.992 | 0.183 | 0.117 | 0.058 | 0.067 | 0.992 |
| Llama-3.1-8B | 1.000 | 0.992 | 0.108 | 0.558 | 0.617 | 1.000 |
| Phi-3.5-mini | 1.000 | 0.233 | 0.000 | 0.000 | 0.117 | 0.983 |
| OLMo-2-7B | 1.000 | 0.492 | 0.000 | 0.017 | 0.058 | 1.000 |
| Qwen2.5-3B | 0.000 | 0.633 | 1.000 | 1.000 | 0.950 | 0.000 |
| Qwen2.5-7B | 0.000 | 0.358 | 0.967 | 0.942 | 0.933 | 0.000 |
| Mistral-7B | 0.000 | 0.042 | 0.858 | 0.900 | 0.875 | 0.000 |
| Llama-3.1-8B | 0.000 | 0.008 | 0.892 | 0.442 | 0.383 | 0.000 |
| Phi-3.5-mini | 0.000 | 0.617 | 1.000 | 1.000 | 0.883 | 0.017 |
| OLMo-2-7B | 0.000 | 0.475 | 1.000 | 0.983 | 0.942 | 0.000 |
表12|物語の prompt での と 。書き換えと は表 7 と同じ。 RoPE の表をモデルの dtype で使って計算した値。float32 の表では 0.625()と 0.375()である(付録 A)。
Bob を問う 書き換えなしでは、6 モデルすべてが、すべての試行で両方の問いに正しく答える。 Bob の問いでは、Qwen2.5-3B は value の入れ替えの基準を満たさず、14.2% の試行で答えが Bob の色のままであり、Llama-3.1-8B では判定不能である(表 1)。
問いの形 形 F2a と F2b では(付録 H.3 の表 13)、答えの分類が入れ替えたもう一方の人の色に変わるのは、Qwen2.5-3B では F2a の Bob の問いで 64.2% の試行、OLMo-2 では F2b の Alice の問いで 78.3% の試行だけで、value の入れ替えの基準が求める 80% に届かない。
ほかの名前と属性 ペット(S2)と飲み物(S3)では、入れ替えたもう一方の人の属性の語は問われた人の属性の語から決まらないので、これらの組での value の入れ替えによる変化(表 9)は、Alice の属性の語の反対を答えることからは生じえない。 満たさない判定と判定不能の判定の多くは、Llama-3.1-8B、Mistral-7B、Qwen2.5-3B のものである。 組どうしは名前、文、属性の語の数でも違うので、組の間の違いを属性だけによるものとはしない。
H.2 attention:1 層の score、すべての層の書き換え、対照
1 層の score (試行、層、選んだ head)の 3 つ組のうち、Alice と Bob の書き換えなしの score の差 (§4.4 節)の大きさが 1 以上のものの集合 は、そのような 3 つ組の大半を占める(表 8)。 attention の重みは移した key の中身に従い、どのモデルでも 、 で(表 8)、試行を resample した 95% の bootstrap 区間はどれも 0 を含まない。 6 モデルのうち OLMo-2 を除くすべてで 40 試行で流すと、1 つの層の key か value を入れ替えたときに Bob の色を答えるのは、多くても 25% の試行である(Qwen2.5-3B の層 31)。 3 人の課題、key の複製の後、長い文書では attention を測っていない。
すべての層を書き換えた後 実行の後に、同じ書き換えた key について、score の変化のうち query だけによる分がどれだけかを測った。 表 8 に、モデルごとに、 の各 3 つ組の 2 つの色の位置について、この変化の絶対値の書き換えなしの score の差 に対する比の中央値と、この比が 1/2 を超える割合を示す。 どちらも Llama-3.1-8B でいちばん大きく、swap-V の後と swap-K の後でほぼ同じである。 すべての層の入れ替えでの query の変化が、書き換えなしの attention で仕組みを表せるほど小さいかは確かめていない。 key の中身に従う 3 つ組の割合は、 から、すべての層の key の入れ替えで計算した である に下がる(表 8)。
問いの形:prompt の中で最後に出る名前 F2a と F2b で、6 モデルと Olmo-3 の は 0.064–0.316、 は から で、どのモデルでも である(式 (27)・式 (28))。 Mistral-7B では、1 つの試行の F2a の 2 つの問いの両方に正しく答えるのが 63.3% の試行()だけで、求める 90% に届かないので判定不能だが、その重みだけなら attention の閾値を満たす()。 この平均は決まった head の集合についてとったもので、形ごとに選び直した head と の Jaccard 係数は F2b では 0.737–0.976 だが F2a では 0.314–0.913 なので、これらの測定は、どの形でも同じ head が使われることを示さない。 もう一方の人の名前を prompt の最後に置いても、「favorite color」の隣の名前のような、より狭い手がかりは除けない。
ほかの名前と属性 色で選んだ元の を 3 つの組に当てると、どの組でも、6 モデルすべてと Olmo-3 で 、、 になる。
H.3 選んだ head が使う KV head、mask、head ごとの knockout
| モデル | 問いの形 | 選んだ head の KV head | |||||
| 問われた人 | 最後の人 | swap-V | phase | 2 人 | 3 人 | ||
| Qwen2.5-3B | ✓ | ✓ | c | c | c | ||
| Qwen2.5-7B | ✓ | ✓ | ✓ | ✓ | |||
| Mistral-7B | ? | ? | ? | ? | ? | ? | ? |
| Llama-3.1-8B | ✓ | ✓ | ? | ? | ? | ||
| Phi-3.5-mini | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
| OLMo-2-7B | ✓ | ✓ | ✓ | ✓ | ✓ | ||
| 満たした数 | 5 | 0 | 2 | 5 | 2 | 2 | 3 |
| Olmo-3-7B | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
表13|ほかの問いの形での対照と swap-V@ での対照の判定。 列は表 3 の基準である:「問いの形・問われた人」「最後の人」「value の入れ替え」「位相」、「選んだ head の KV head」(2 人)、「選んだ head の KV head・3 人」(3 人)、「選んだ head の KV head・」。 Olmo-3-7B は「満たした数」の行に数えない。 ✓:満たす、:満たさない、?:判定不能、c:構成上判定不能。
選んだ head が使う KV head の value Olmo-3 では、swap-V@ で答えが Bob の色に変わる試行の割合は 100.0% で、無作為な集合では 0% である。 3 人では、 の value だけを入れ替えると、Phi-3.5-mini で 98.3%、OLMo-2 で 99.2%、Olmo-3 で 98.3% の試行の答えが入れ替えたもう一方の人の色に変わり、3 人目の色に変わる試行は無く、最初の 3 つの無作為な集合では、入れ替えたもう一方の人の色に変わる試行は多くても 2.5% である。
Qwen2.5-7B では、選んだ head が使う KV head で 94.2% [89.2%, 97.5%] の試行の答えが Bob の色に変わるが、無作為な 10 個の集合の 1 つでも、Bob の色に変わる試行の割合は 94.2% である。 そのため、どの無作為な集合よりも 20 ポイント多いことを求める基準は、選んだ集合の割合が無作為な集合の平均を 51.2 [47.8, 54.6] ポイント上回るものの、満たされない。 head (付録 G.6)が使う KV head は、同じ試行で評価した の部分集合なので、この分析は独立な再現ではない。 この KV head では、Qwen2.5-7B でも基準を満たす(表 13)。
選んだ head が使うものを除くすべての KV head 選んだ head が使うものを除くすべての KV head を入れ替えると、6 モデルのどれでも Olmo-3 でも答えが Bob の色に変わる試行は無いが、そのとき は Mistral-7B で 65.8%、Llama-3.1-8B で 30.8% である。
mask key だけか value だけの入れ替えの後の mask は、答えが Alice の key の中身を持つ位置に依るかを調べるが、この位置は Bob の value も持つので、この確かめは key と value を分けず、下がってもほかの位置からの寄与は否定されない。 mask では、位置 を のすべての query から、すべての head で mask し、head ごとの knockout では、1 つの head の集合でだけ mask する(付録 G.6)。 2 人では、一方の位置を mask すると見える色の語の token が 1 つだけになるので、見える色で答えるモデルは、key がその位置を選んでいなくても 2 人の確かめを通りうるが、3 人では色の語の token が 2 つ見えたままである。 2 人では、swap-K か swap-V の後、そのとき Alice の key の中身を持つ位置を mask すると が 50 ポイント以上下がり、もう一方の位置を mask しても 10 ポイント以下しか下がらないのは、OLMo-2、Phi-3.5-mini、Qwen2.5-3B である。 残る 3 モデルでは、 の答えのため判定不能である。 3 人では、key の入れ替えの後、入れ替えたもう一方の人の位置を mask するとその人の色に分類される答えの割合が 50 ポイント以上下がり、Carol の位置を mask しても 10 ポイント以下しか下がらないのは同じ 3 モデルである。 残る 3 モデルと Olmo-3 では、3 人の判定は判定不能である。
head ごとの knockout 書き換えなしで head から Alice の色を表す token への辺を止めても、Alice の色に分類される答えの割合は 0–23.3 ポイントしか下がらず、正の対照が求める 30 ポイントに届かないので、head ごとの knockout は 6 モデルとも判定不能である。
H.4 key の複製と、Alice の色を表す token が無いときの Alice の色
key の複製 Alice の key の中身を Bob の位置に写すと(dupK_AB)、2 種類の prompt とも、OLMo-2、Phi-3.5-mini、Qwen2.5-3B では試行の 20% 以上で答えの分類が Alice の色から外れ、残る 3 モデルでは 0%--0.8% の試行である。 定型文の prompt では、答えの分類はおもに Bob の色へ移る(表 8)。 Qwen2.5-3B と Phi-3.5-mini で答えが変わるのは、Alice の事実が先の試行だけである。 Bob の key の中身を Alice の位置に写すと(dupK_BA)、 が 50 ポイント以上下がるのは、判定が定まったモデルの中では Qwen2.5-7B だけで、100.0% から 50.0% へ下がる。 dupK_BA の基準は、6 モデル中 4 モデルで満たさず、答えがすべて の Mistral-7B では判定不能であり、物語の prompt では満たすモデルは無く、3 モデルで判定不能である。 満たした key の複製の判定の一部は、閾値ちょうどかその近くにある(付録 C)。 重みを記録するのに使った attention の関数(付録 A)では、Qwen2.5-7B の dupK_BA は になるので、その判定は判定不能になる。 ペットと飲み物では、色では 3 モデルで満たす dupK_AB の基準を満たすモデルは 6 モデルのうち 1 つも無く、答えの分類が Alice の属性の語から外れるのは 0%--17.5% の試行だけである。
Alice の色を表す token が無くても残る Alice の色 Alice の色を表す token は、Alice の色にいつも必要なわけではなく、それを mask しても(mask-A)、Alice の色が残る試行は、定型文の prompt で Llama-3.1-8B が 100.0%、OLMo-2 が 44.2%、Qwen2.5-7B が 35.0%、物語の prompt で 99.2%、49.2%、34.2% である。 3 人の課題では、mask の基準を満たす 3 モデルで、key の入れ替えの後に入れ替えたもう一方の人の色を答える試行で、さらにその人の位置も mask する。 すると答えは、全 120 試行に対して 26.7%--55.0% で Alice の色に、35.8%--65.8% で Carol の色に変わる。
H.5 Llama-3.1-8B:事実の順と最後の位置
事実の順 定型文の prompt で Bob の事実が先の 58 試行では、swap-V と swap-K は Bob の色をまったく答えさせず(§4.3 節)、そのうち 46 と 47 の試行では、答えが代わりに Alice の元の色を Bob のものだと述べる("color is actually Bob's favorite ...")。 物語の prompt では、key の入れ替えを float32 の RoPE の表で計算した版(全体の割合 37.5%、付録 A)で、Bob の色を答える割合は Alice の事実が先で 56.9%(swap-V)と 61.5%(swap-K)、Bob の事実が先で 29.1% と 9.1% である。 定型文の prompt では、patch-V は事実のどちらの順でもすべての試行で Bob の色を答えさせる(表 7)ので、Llama-3.1-8B は書き換えた value を読んでいる。 ただし、このとき 2 つの位置は同じ色を持つので、この書き換えでは、答えの色がどちらの位置から来たかは分からない。 swap-V、swap-K、patch-V の後の答えで、書き換えなしの答えと同じ文字列のものは無い(それぞれ 120 中 0)。
定型文の prompt の最初の 40 試行で、最後の位置の始まりを 1 token ずつ前へ動かす。 assistant の見出しの token <|start_header_id|> を含めると、次の token から始めたときより が value の入れ替えで 45 ポイント、key の入れ替えで 40 ポイント上がり、prompt の最後の token と生成した token だけに書き換えを読ませたときの書き換えなしからの上がり幅(38 ポイントと 48 ポイント)と同じくらいである。 考えられる説明の 1 つは、Li [10] で後ろの区切りの token が prompt の前の項目から計算した判断を運ぶように、この token が元の色を後ろへ運んでいることであり、どの位置がその色を運ぶかは測っていない。
2 つの色を表す token のうち後ろのものの直後の位置から先で書き換えを読ませると、2 つの token の間の位置は元の計算のままになる。 このとき Llama-3.1-8B で swap-V と swap-K の後に Bob の色を答える割合は、40.0% と 45.8% から 80.0% と 74.2% に上がり、swap-KV は 100.0% の試行で Alice の色を保つ。 2 つの割合は、Alice の事実が先で 100% と 98%、Bob の事実が先で 59% と 48% である。 この形で流したほかの 4 モデル(Qwen2.5-3B、Qwen2.5-7B、Mistral-7B、Phi-3.5-mini)では、swap-V と swap-K は 64.2%--98.3% の試行で Bob の色を答えさせる。
H.6 長い文書:文脈の長さ、予備の実験、検証の prompt
| モデル | 書き換えなしの の最小 | |||
|---|---|---|---|---|
| Qwen2.5-3B | 0.342 [0.150, 0.525] | 0.033 [<!-- -->{=html}0.025, 0.125] |
0.308 [0.117, 0.492] | 0.983 |
| Qwen2.5-7B | 0.308 [0.108, 0.508] | 0.117 [<!-- -->{=html}0.058, 0.308] |
0.192 [<!-- -->{=html}0.042, 0.433] |
0.992 |
| Llama-3.1-8B | 0.100 [<!-- -->{=html}0.100, 0.283] |
[<!-- -->{=html}0.200, 0.175] |
0.117 [<!-- -->{=html}0.125, 0.350] |
0.958 |
| Mistral-7B | 0.417 [0.217, 0.600] | 0.225 [0.042, 0.417] | 0.192 [0.025, 0.375] | 0.833 |
| Phi-3.5-mini | [<!-- -->{=html}0.250, 0.142] |
0.100 [<!-- -->{=html}0.025, 0.250] |
[<!-- -->{=html}0.317, 0.008] |
0.875 |
| Olmo-3-7B | 0.183 [<!-- -->{=html}0.017, 0.383] |
0.292 [0.092, 0.492] | [<!-- -->{=html}0.283, 0.083] |
0.667 |
| OLMo-2-7B | 0.192 [0.067, 0.317] | 0.208 [0.092, 0.325] | [<!-- -->{=html}0.167, 0.133] |
0.883 |
表14|約 1k token から最も長い長さまでの、key の入れ替え()と value の入れ替え()での の下がり幅(§4.6 節)。 角括弧:試行を resample した 95% の bootstrap 区間(付録 C)。 最後の列:書き換えなしの の、長さをまたいだ最小。 Olmo-3-7B:最も長い長さでは full attention の 8 層だけを入れ替える。最も長い長さは約 3.5k token。
文脈の長さ 約 1k・4k token では、とくに mask-A で、6 token の中にどちらの色も含まない答えがあるので、そこでの割合は、答えの後のほうに出る色を数え落としうる。 物語の prompt の短い文脈から約 16k token まで、key の入れ替えでの Bob の色は、Qwen2.5-3B で 95% から 29% へ、Qwen2.5-7B で 93% から 42% へ下がり、value の入れ替えでは 100% から 96% へ、94% から 75% へ下がる。 これらの下がりは 2 段から成り、どちらも長さだけによるものとはしない:1 段目は決まった型から作った短い prompt から約 1k token の Wikipedia の文書へで、ここでは文書の種類も変わり、2 段目は同じ作りの Wikipedia の中での約 1k から 16k token へである。 Llama-3.1-8B の key の入れ替えの効果は約 1k token で既に小さい(35%)ので、その下がり幅は key についてほとんど何も言わない。 図 4 のこのモデルの短い文脈の key の入れ替えの点(37.5%)は float32 の RoPE の表の実行から来ており、表 12 はモデルの dtype の値 38.3% を示す(付録 A)。 Olmo-3 では value の効果のほうが key の効果より大きく下がり、約 1k から 16k token で、value の入れ替えでは 87.5% から 58.3%、key の入れ替えでは 55.8% から 37.5% である。 ただし 16k では full attention の 8 層だけを入れ替えるので、長さの効果を、層の範囲からも、問われた色を含まない書き換えなしの答えからも分けられない。 OLMo-2 の約 1k と 3.5k token の実行は、書き換えのために作った cache が書き換えなしの答えを再現するかの照合で、それぞれ 1 試行ずつ外れた。 どちらの外れも Alice の色は保たれていて、書き換えた答えへの影響は確かめていない。 key と value の両方の入れ替えでも Alice の色が残りにくくなり、短い文脈から約 16k token までで、Qwen2.5-3B は 100% から 46%、Qwen2.5-7B は 100% から 67%、Mistral-7B は 99% から 58% で、Mistral-7B が書き換えなしで Alice の色を答える割合は約 16k で 83.3% である。
長い文書での検証の prompt とモデル 付録 D の prompt では、2 つの色を表す token は、187–704 token 離れる(近い)か、1,757–2,852 token 離れる(遠い)。 Qwen2.5-3B、Qwen2.5-7B、Mistral-7B は、3 つの長さの結果で key と value の両方の入れ替えが長い長さで Alice の色を下げていたので入れた。 Llama-3.1-8B はkey と value の両方の入れ替えでも Alice の色が高いまま残ったモデル(約 16k token で 88%)として、Olmo-3 と OLMo-2 は multi-head attention を持ち学習の手順が公開されたモデルとして入れた。 Phi-3.5-mini は、4k token を超えると RoPE の scaling が変わり、RoPE の変化と長さが混ざるので除く。